
Global Marché des Stockage Native Cloud Size & Prévision:
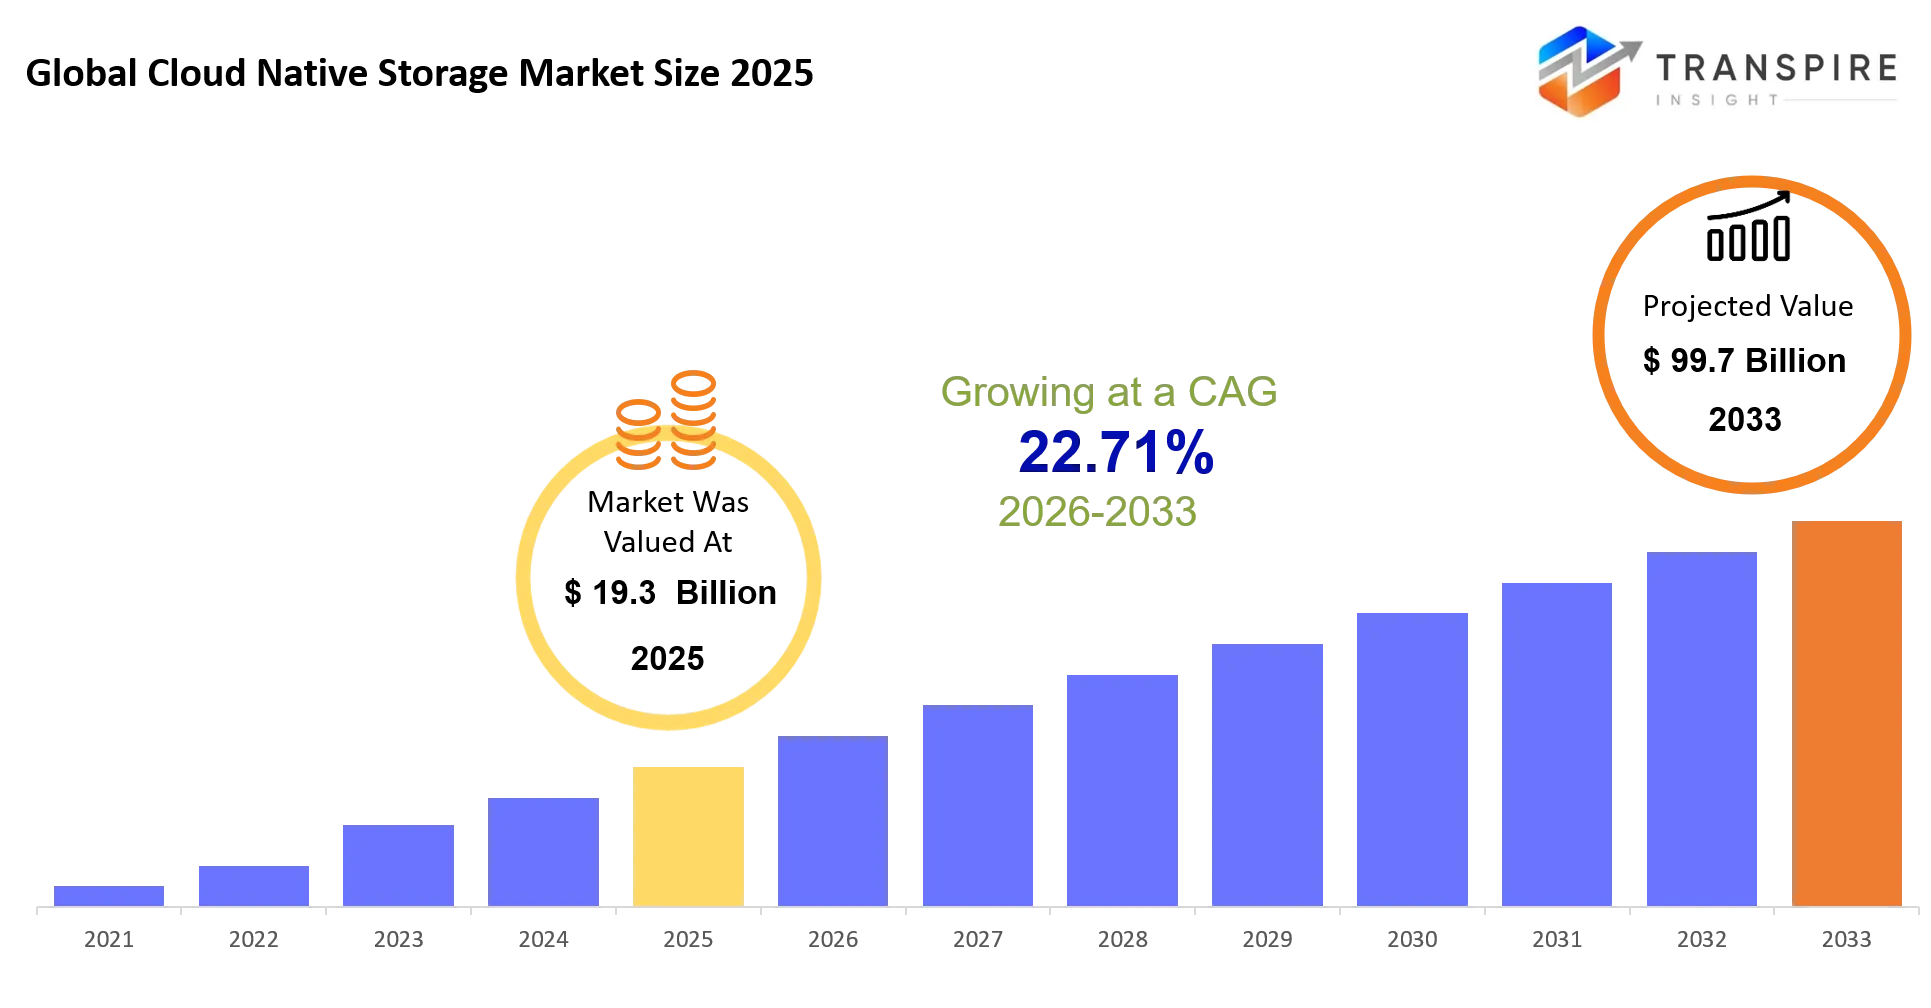
- Global Marché des Stockage Native Cloud Taille 2025 : 19,3 milliards de dollars
- Global Marché des Stockage Native Cloud Taille 2033: 99,7 milliards de dollars
- Global Marché des Stockage Native Cloud TCAC : 22,71 %
- Global Marché des Stockage Native Cloud Segments: Par composant (Block Storage, Object Storage, File Storage, Software, Services, Others); Par déploiement (Public Cloud, Private Cloud, Hybrid Cloud, Multi-cloud, Others); Par application (Conteneurs, DevOps, AI Workloads, Database Management, Backup & Recovery, Others); Par utilisateur final (IT & Telecom, BFSI, Healthcare, Retail, Manufacturing, Others); Par taille de l'organisation (Grandes entreprises, PME, Others)
Global Marché des Stockage Native Cloud Résumé
Selon Transpire Insight Analysis, la taille du Global Marché des Stockage Native Cloud est estimée à 19,3 milliards de dollars en 2025 et devrait atteindre 99,7 milliards de dollars d'ici 2033, soit une augmentation de 22,71% entre 2026 et 2033. Ce secteur d'infrastructure de données haute performance fournit les architectures de stockage définies par logiciel, les pilotes de volume persistants et les plateformes de gestion de données synchronisées en nuage nécessaires pour fournir un stockage dynamique directement aux applications conteneurisées et aux microservices. Au cours des dernières années - l'adoption d'une entreprise explosive de Kubernetes a forcé les équipes d'ingénierie à abandonner les configurations SAN et NAS rigides et anciennes liées au matériel en faveur de tissus de données hautement évolutives, prêts à l'éphémère. Cette progression a déclenché un changement structurel massif au fur et à mesure que les organisations ont élargi leurs pipelines d'IA génératifs et leurs charges de travail de base de données en temps réel, ce qui a nécessité le stockage de données qui se trouve immédiatement aux côtés des conteneurs. En assurant un stockage régulier et à faible latence pour les grappes de conteneurs en mouvement rapide, ces systèmes éliminent complètement les goulets d'étranglement d'accès aux données et empêchent les temps d'arrêt des applications, ce qui entraîne l'adoption massive de cloud d'entreprise.
Principales perspectives du marché
Le paysage mondial du stockage natif des nuages - en cours de changement de paradigme structurel, passant rapidement des volumes persistants de base aux tissus de données distribués à faible latence optimisés pour les grappes de conteneurs et les pipelines d'apprentissage automatique. En raison de l'exigence critique de supporter les flux de travail à haute vitesse DevSecOps et l'ingestion de données en temps réel, les entreprises mondiales échangent des réseaux de stockage statiques liés au matériel pour des nœuds de stockage définis par logiciel qui fournissent dynamiquement aux côtés des microservices.
- Verrouiller une part de marché dominante de 38 %, Les solutions de stockage d'objets mènent la matrice des composants, avec NetApp lançant sa plateforme StorageGRID 12.1 pour étendre la livraison de données non structurées jusqu'à 12 To/s pour les usines intensives d'IA d'entreprise.
- Élargissant à un TCAC autonome accélérant le marché de 19,5% dans sa matrice, AI Workload Storage Solutions domine la croissance des applications à mesure que les développeurs passent des journaux de bases de données traditionnels aux magasins vecteurs persistants.
- Captant 47 % du chiffre d'affaires mondial, l'Amérique du Nord est le plus grand marché géographique, soutenue par des empreintes massives de data centers hyperscalers et une orchestration très répandue de Kubernetes.
- Stimulant la croissance du marché avec un TCAC régional massif de 21,3%, le théâtre Asie-Pacifique est le territoire qui connaît la croissance la plus rapide, alimenté par des mandats agressifs de migration du nuage dans les banques commerciales et les secteurs régionaux des télécommunications.
- Forte d'un marché stable de 24 %, l'Europe conduit à une stricte conformité du système et à la souveraineté des données, poussant les équipes logicielles d'entreprise à mettre en place des plans de stockage localisés et multicloud conformes aux lois régionales strictes en matière de données.
- Sécurisant 23 % du chiffre d'affaires total des composantes, Block Storage demeure une base essentielle pour les applications critiques de la mission, avec Pure Storage intégrant son architecture native Cloud Azure dans les moteurs Live Purity//FA pour orchestrer des instantanés VMFS à faible latence.
- Représentant 15 % de la demande totale de l'industrie, les configurations de stockage de fichiers font face à une forte modernisation, les fournisseurs déployant des volumes de fichiers partagés natifs sur les plateformes AWS, Azure et Google Cloud pour gérer des grappes massives de bases de données multi-tenues.
- Comptant pour une tranche ciblée de 10 % de l'empreinte du marché, les Services professionnels se développent rapidement dans les configurations d'infrastructures hybrides, avec des groupes TI mondiaux nécessitant un soutien spécialisé du cycle de vie pour refactorer le stockage hérité dans des conceptions de conteneurs-natifs.
- La région du Moyen-Orient et de l'Afrique, qui revendique une présence intégrée de 5 % sur le marché, représente une zone de développement émergente, favorisant la transformation du cloud dans le secteur public grâce au déploiement de centres de données des villes intelligentes.
- Captant la tranche restante de 3% du chiffre d'affaires mondial, l'Amérique latine évalue son empreinte DevOps moderne, en s'appuyant sur des couches de stockage définies par abonnement pour optimiser le développement d'applications d'entrée de gamme.
Quels sont les principaux moteurs, les restrictions et les possibilités du marché mondial des stocks Native Cloud?
Chauffeur
L'expansion du marché est fortement propulsée par l'explosion à l'échelle de l'entreprise d'applications conteneurisées d'état et de déploiements de bases de données en temps réel dans les environnements de Kubernetes. Les configurations SAN et NAS traditionnelles liées au matériel ont été conçues pour les machines virtuelles statiques, ce qui a entraîné de graves retards de fourniture et des goulets d'étranglement dans l'accès aux données lorsqu'elles étaient liées à des microservices éphémères. Cette friction a déclenché un déplacement structurel vers logiciel-des tissus de stockage définis et natifs qui s'échellent instantanément - allouent dynamiquement et reproduisent automatiquement les données de volume aux côtés des calendriers des contenants vivants. Ce refactoring étendu de l'infrastructure entraîne des revenus massifs d'abonnement et de logiciel, car les équipes d'ingénierie de DevOps et de plate-forme investissent dans des architectures de données résistantes et basées sur l'API pour éviter les pannes d'applications.
Dispositif de retenue
La forte cohérence des données structurelles, la sécurité et les frictions de configuration de réseau dans des environnements multicloud et hybrides agissent comme un déploiement rapide de drag curning majeur. La gestion de volumes d'état persistants dans des contenants très distribués et à courte durée de vie introduit d'immenses latences de synchronisation, une cartographie complexe des défaillances et des risques accrus de vulnérabilité aux cyberattaques externes. Cette complexité persiste parce que les environnements natifs de Kubernetes manquent intrinsèquement de systèmes de fichiers mondiaux standard et croisés, obligeant les architectes de réseaux d'entreprise à construire des scripts de réplication personnalisés et fragiles qui gonflent lourdement les coûts de gestion de l'infrastructure et retardent le déploiement d'applications à grande échelle.
Possibilités
La fenêtre de croissance la plus lucrative réside dans le développement d'un stockage d'objets-conteneurs à haut débit hyperspécialisé optimisé pour le calcul des bords distribués et les pipelines intensifs d'inférence de modèles d'IA. La fusion de couches de cache de données à faible latence avec des pilotes de base de données vectorielles natifs hébergés dans le cloud permet aux organisations de traiter en toute sécurité les ensembles de données vidéo, télémétriques et texte spatial non structurés bruts au bord du réseau. Cette transition structurelle permet de dégager des revenus logiciels hautement rentables et récurrents, car les réseaux de télécommunications et de fabrication automatisée investissent dans des couches de données conteneurisées et prêtes à l'IA pour éliminer les coûts de transfert de données infonuagiques entre les régions et réaliser une exécution locale instantanée.
Quel a été l'impact de l'intelligence artificielle sur le Marché mondial des Stockage Native Cloud ?
L'intelligence artificielle réinvente complètement le stockage natif du cloud, en éloignant la gestion de l'infrastructure de la partition manuelle complexe vers le routage automatisé de la couche de données. Au lieu d'exiger des administrateurs de bases de données qu'ils optimisent manuellement les piscines de stockage des pods Kubernetes hautement volatils, les plates-formes de conteneurs déploient des moteurs d'apprentissage automatique intégrés pour surveiller le trafic de lecture-écriture en temps réel et d'évaluer automatiquement les volumes de stockage persistants à la volée.
À l'intérieur d'environnements distribués massifs, les modèles d'IA intégrés conduisent à des améliorations opérationnelles grâce à la remise en état de stockage prédictive et à des optimisations de cache actives. Ces algorithmes évaluent continuellement les fréquences d'accès aux données dans les magasins d'objets non structurés et les seaux en version, en prédisant exactement quels ensembles de données nécessitent une exécution flash NVMe haute performance et qui peuvent être déplacés vers des niveaux de stockage moins chers. En anticipant la dégradation des performances, le système exécute automatiquement des nettoyages de niveau préfixe et équilibre le trafic avant que les goulots d'étranglement des données ne décroissent les grappes de traitement.
Cependant, une grave limitation opérationnelle persiste autour de frais généraux élevés de calcul des ressources. L'utilisation de moteurs de déduplication de données basés sur l'intelligence artificielle et la similarité à l'intérieur du tissu de stockage draine une importante puissance CPU et GPU - créant une taxe de performance qui peut ralentir par inadvertance les microservices transactionnels primaires.
En mai 2026, le pionnier du stockage d'objets cloud-native MinIO a officiellement dévoilé ses capacités avancées de plate-forme AIStor, en lançant une boîte à outils d'administration du système AI-Augmented spécialement conçue pour gérer la récupération de stockage en version à une échelle massive d'exaoctet. Ce cadre d'automatisation intègre les modèles d'apprentissage profond directement dans les pipelines de conteneurs standard pour remplacer les scripts de nettoyage manuel par une optimisation précise de l'espace au niveau préfixe. En identifiant et en récupérant automatiquement les empreintes de données abandonnées sur des milliers de seaux distribués, la plate-forme permet aux ingénieurs de la plate-forme de supprimer les frais généraux de stockage du nuage sans risquer la suppression accidentelle de données actives.
Marché clé Tendances
L'espace de stockage natif du cloud s'éloigne des configurations verrouillées spécifiques à l'environnement vers des plans de contrôle de données unifiés qui traversent des nuages hybrides. Poussés par la montée en flèche des coûts de virtualisation hérités et la nécessité d'exécuter des modèles d'IA lourds à la limite, les entreprises abandonnent les moteurs de stockage rigides et à simple vendor pour les configurations de données de conteneur-native.
- Les équipes DevOps ne regardaient que les volumes temporaires de base pour les microservices simples apatrides, mais elles s'orientent maintenant vers un stockage continu à l'échelle de l'entreprise, construit pour gérer des bases de données transactionnelles lourdes et de qualité de production.
- Au lieu de lancer des grappes de stockage d'objets géantes et généralisées à l'intérieur de datacenters de cloud lointains, les équipes d'ingénierie passent à des nœuds de stockage légers et natifs pour traiter localement des données de télémétrie industrielle.
- Les architectes de systèmes utilisaient les plug-ins de base de Container Storage Interface (CSI) pour gérer la cartographie de volume simple, mais les développeurs coupent maintenant l'intermédiaire en intégrant directement la mise en commun NVMe accélérée du matériel dans le noyau du système d'exploitation en direct.
- Plutôt que de gérer des environnements totalement séparés et déconnectés pour les applications de conteneurs modernes et les anciennes machines virtuelles, les entreprises combinent ces charges de travail hybrides en un seul plan de contrôle Kubernetes via des outils comme KubeVirt.
- Les ingénieurs de bases de données s'éloignent des structures de fichiers relationnels traditionnelles pour déployer des grappes de stockage vectorielle très évolutives et persistantes conçues pour gérer des boucles de récupération d'IA en temps réel.
- Les équipes d'infrastructure passaient des semaines à écrire des scripts personnalisés fragiles pour gérer la reprise après sinistre multi-régions, mais elles adoptent rapidement la réplication automatique et active de données multi-cloud pour maintenir les systèmes en ligne 24/7.
- Des secteurs hautement réglementés comme la finance s'éloignent des pools de données cloud ouverts et partagés pour déployer des maillages de sécurité serrés qui vérifient automatiquement les lois sur les données et les autorisations d'accès directement au niveau du seau.
- Les équipes de Cloud cherchent à développer leur capacité matérielle de base bien avant, en se concentrant plutôt sur des outils automatisés de duplication pilotés par l'IA qui nettoient l'espace vide et réduisent les factures de cloud.
- Pour atteindre de nouveaux objectifs de réduction du carbone et de nouveaux mandats d'énergie, les opérateurs de datacenter se débarrassent de vieux réseaux de stockage mécanique à faible puissance et les échangent contre des lecteurs flash à haute densité refroidis par liquide.
Global Marché des Stockage Native Cloud Segmentation
Par composante
Object Storage détient la plus grande part du capital de marché, détenant une part dominante de 38 % du revenu mondial en raison de ses capacités à grande échelle, de l'étiquetage intégré des métadonnées et de l'adoption généralisée dans des dépôts de données non structurés. Block Storage suit de près à 23%, Fichier Stockage 15 %, tandis que les Services et les plateformes logicielles représentent les 24 % restants de l'empreinte opérationnelle. Cette division est façonnée par le contraste architectural entre l'exécution transactionnelle à grande vitesse et l'échelle massive de dépôt distribué. Object Storage maintient sa position de pointe car les pipelines d'IA d'entreprise et les moteurs vectoriels hébergés dans le cloud nécessitent de vastes bassins de données non structurées qui peuvent être accessibles à l'échelle mondiale via de simples API RESTful. Avancer, les technologies structurelles vont pivoter vers des moteurs de données multiprotocoles hyper-convergés, forçant les développeurs de stockage à construire des systèmes de stockage unifiés capables de servir des seaux d'objets bruts aux côtés de volumes de blocs à grande vitesse à partir d'une seule couche flash.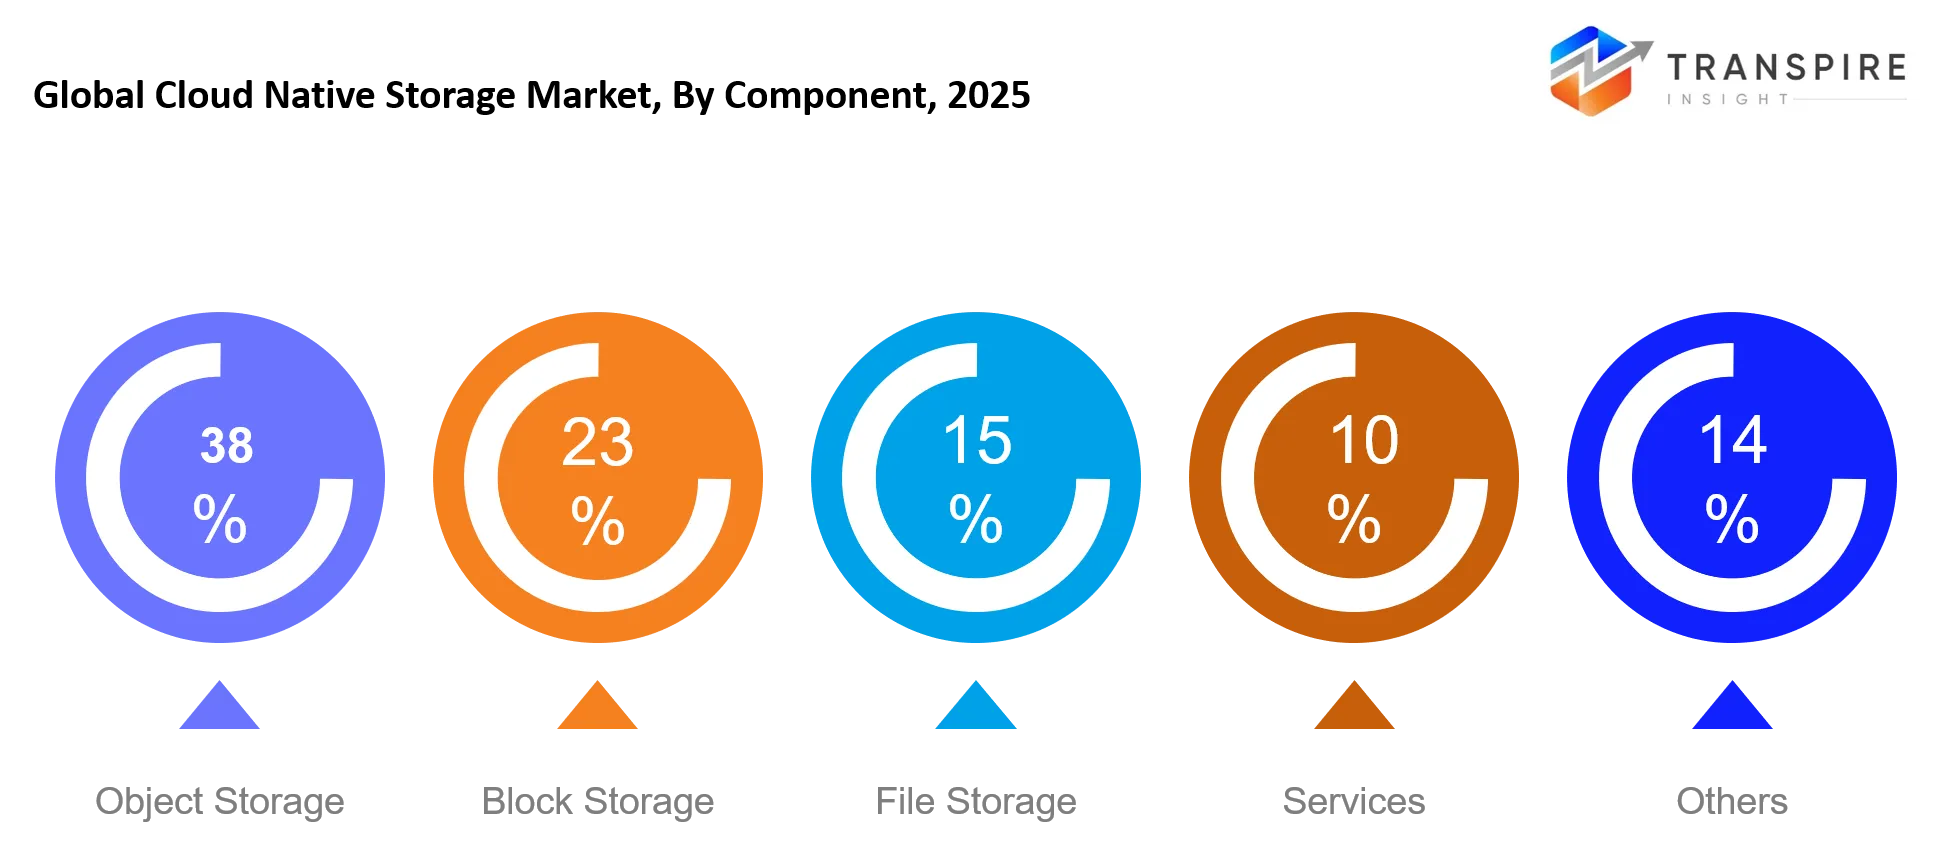
Par déploiement
Les plates-formes Public Cloud conservent une emprise de commande sur ce segment, verrouillant une partie dominante de l'ensemble des revenus de l'industrie, tandis que les environnements Hybrid Cloud suivent la norme opérationnelle qui connaît la croissance la plus rapide. L'infrastructure Cloud privée capte une part secondaire stable, les configurations Multi-cloud se développant rapidement en tant que couche critique d'urgence d'entreprise. La logique de croissance sous-jacente est directement liée à l'équilibre entre l'agilité immédiate des développeurs et les mandats de souveraineté des données d'entreprise. Public Cloud est le leader du marché, car les équipes d'ingénierie logicielles modernes préfèrent l'approvisionnement instantané, l'échelle de capacité infinie et le modèle financier payant des réseaux de stockage hyperéchelleurs. Pour aller de l'avant, les stratégies de déploiement se concentreront fortement sur l'abstraction complète de la couche d'infrastructure sous-jacente, obligeant les fournisseurs de cloud à fournir des avions de données sans frontières gérés par Kubernetes qui permettent aux volumes d'états de flotter en douceur entre les nœuds sur site et plusieurs régions publiques sans perte de données.
Par demande
Les workflows Containers et DevOps fonctionnent comme l'ancre incontestée de cette matrice, tandis que les Workloads AI se distinguent comme le moteur du marché qui accélère le plus rapidement, augmentant à un TCAC autonome élevé de 19,5 %. Les systèmes de gestion et de sauvegarde des bases de données et de récupération sont des normes opérationnelles essentielles pour les équipes de conformité. Ce modèle de distribution est motivé par la transition de l'entreprise des modules d'application temporaires et apatrides vers des systèmes de traitement à forte intensité de données. Les conteneurs mènent la position du marché parce que les pipelines de développement moderne comptent sur Kubernetes pour faire tourner et démolir des milliers d'instances de microservice quotidiennement, nécessitant un stockage qui peut suivre un calendrier automatisé rapide. À l'avenir, le développement d'applications se concentrera fortement sur l'optimisation des bases de données vectorielles spécialisées et les magasins de fonctionnalités à faible latence, obligeant les architectes de stockage à intégrer des couches de cache de données intelligentes et en temps réel directement dans les environnements d'exécution des conteneurs primaires.
Par Utilisateur final
Les réseaux IT & Telecom sont le moteur financier principal du marché, contrôlant les budgets d'infrastructure massifs en déployant rapidement des réseaux de base 5G ouverts et natifs du cloud et des nœuds informatiques de pointe. Parallèlement, BFSI, Healthcare et Retail représentent des acheteurs secondaires très actifs et à croissance rapide. La dynamique du marché repose ici sur l'évolution des exigences de conformité et de densité transactionnelle de différentes entreprises modèles, où les banques exigent la durabilité du grand livre à temps zéro et les détaillants cherchent l'évolutivité rapide de l'application de commerce électronique. IT & Telecom utilise le stockage natif de conteneurs pour orchestrer instantanément les charges de travail de virtualisation des fonctions réseau à haut débit (VAN), tandis que les entreprises financières l'utilisent pour soutenir les applications de détection de fraude en temps réel. Pour aller de l'avant, le succès du marché exigera un pivot total vers des profils de stockage spécifiques à l'industrie, obligeant les fournisseurs de plate-forme à fournir des modèles de stockage préconfigurés qui répondent nativement à des réglementations sectorielles strictes comme HIPAA et PCI-DSS immédiatement hors de la boîte.
Selon la taille de l'organisation
Les grandes entreprises détiennent la plus grande part du capital de marché, occupant une position dominante dans le chiffre d'affaires mondial en raison de l'ampleur massive de leurs efforts de modernisation de l'application et de leurs dépenses étendues en TI dans le nuage hybride. Les petites et moyennes entreprises (PME) sont le groupe secondaire qui connaît la croissance la plus rapide, qui est motivé par leurs stratégies d'affaires numériques et par l'absence totale d'endettement technique. Cette division persiste parce que les systèmes de base de données multi-régions et conteneurisés sur des réseaux mondiaux massifs nécessitent une expertise technique importante et des ressources en génie profond. Les grandes entreprises maintiennent leur position de pointe parce que les entreprises mondiales doivent gérer des empreintes de données massives à l'échelle des pétaoctets dans plusieurs régions géographiques disparates tout en maintenant les données conformes aux lois locales sur la protection de la vie privée. A l'avenir, l'industrie va pivoter fortement vers l'automatisation opérationnelle zéro contact, forçant les plates-formes de stockage à fournir simplifié, faible-overhead gestion des logiciels les suites qui permettent aux petites équipes informatiques du milieu du marché de déployer et d'exécuter facilement des architectures de données complexes de qualité entreprise.
Quels sont les principaux cas d'utilisation qui conduisent le Global Marché des Stockage Native Cloud?
Le déploiement dominant du stockage d'objets à hyperéchelle est fortement motivé par l'ingestion massive de données non structurées pour la formation en IA et l'analyse des mégadonnées. Les ingénieurs de la plate-forme s'appuient sur des seaux d'objets natifs de conteneurs pour gérer des bassins d'entraînement massifs à l'échelle des pétaoctets et des bases de données vectorielles persistantes, permettant ainsi aux pipelines d'apprentissage automatique distribués d'alimenter directement les jetons d'entraînement en nœuds de conteneurs vivants sans chute de performance.
Au-delà des architectures d'IA, l'expansion du déploiement est visible à travers les cadres de DevOps de l'entreprise exécutant des bases de données d'applications d'état critiques comme PostgreSQL et MySQL à l'intérieur de Kubernetes. Les équipes de développement utilisent des nœuds de stockage de blocs accélérés pour exécuter des pipelines d'intégration et de déploiement continus (IC/CD), garantissant que les applications transactionnelles lourdes maintiennent des vitesses de traitement de données inférieures à la milliseconde et des instantanés instantanés de volume instantanés même lors de redémarrages soudains de conteneurs.
Les nouveaux cas d'utilisation opérationnelle mettent l'accent sur le traitement de la télémétrie par calcul de bord dans les usines de fabrication automatisée et les réseaux de télécommunications 5G. Les architectes réseau déploient activement des nœuds de stockage légers et optimisés pour collecter localement des journaux de capteurs industriels en temps réel, ce qui permet une analyse immédiate des données à la frontière du réseau avant de synchroniser en toute sécurité les enregistrements consolidés vers les nuages hybrides primaires.
| Statistiques | Détails |
| Valeur de la taille du marché en 2025 | 19,3 milliards de dollars |
| Valeur de la taille du marché en 2026 | 23,8 milliards de dollars |
| Prévisions de recettes en 2033 | 99,7 milliards de dollars |
| Taux de croissance | TCAC de 22,71 % de 2026 à 2033 |
| Année de référence | 2025 |
| Données historiques | 2021 - 2024 |
| Période de prévision | 2026 - 2033 |
| Couverture du rapport | Prévisions de revenus, contexte concurrentiel, facteurs de croissance et tendances |
| Portée régionale | Allemagne, États-Unis, Canada, Mexique, Royaume-Uni, France, Italie, Espagne, Chine, Émirats arabes unis, Japon, Inde, Australie, Corée du Sud, Singapour, Brésil, Argentine et Sud |
| Profil d'entreprise clé | NetApp, Dell Technologies, Pure Storage, VMware, Red Hat, IBM, AWS, Microsoft, Google Cloud, Portworx, SUSE, VAST Data, Nutanix, HPE, Oracle |
| Portée de la personnalisation | Personnalisation gratuite des rapports (pays, région et segment). Avail options d'achat personnalisées pour répondre à vos besoins de recherche exacts. |
| Segmentation du rapport | Par composant (logiciel, stockage de fichiers, stockage d'objets, stockage de fichiers, services, autres); Par déploiement (nuage public, Cloud privé, Cloud hybride, multicloud, autres); Par application (conteneurs, DevOps, charge de travail AI, gestion de base de données, sauvegarde et récupération, autres); Par utilisateur final (IT & Télécom, BFSI, soins de santé, commerce de détail, fabrication, autres); Par taille de l'organisation (grandes entreprises, PME, autres) |
Quelles sont les régions qui sont à l'origine de la croissance mondiale des nuages indigènes?
L'Amérique du Nord conserve une emprise de premier plan sur le marché du stockage natif des nuages, ce qui représente 47 % des revenus mondiaux de l'industrie. Ce leadership géographique est fortement motivé par la présence d'hyperscaleurs majeurs, comme AWS, Microsoft et Google Cloud, en plus d'investissements massifs dans des infrastructures d'IA de pointe. L'écosystème régional est structurellement soutenu par une culture d'entreprise mature de l'orchestration de Kubernetes, où les entreprises exigent des moteurs de stockage de conteneurs hautement résistants et à haut débit pour soutenir leurs pipelines de données opérationnelles en temps réel. Par conséquent, le passage des silos matériels existants à des nœuds de stockage définis par un logiciel est devenu la norme de base pour les entreprises nationales qui exécutent des charges de travail complexes à plusieurs nuages. En mai 2026, le pionnier californien du stockage d'objets MinIO a officiellement annoncé la création de MemKV, un magasin de mémoire contextuelle conçu pour fournir une recherche de contexte microseconde à l'échelle du petabyte pour les charges de travail d'inférence d'IA agentique dans les grappes GPU. Ce déploiement d'architecture utilise le transport RDMA de bout en bout pour déplacer les caches à valeur clé directement de la mémoire GPU vers le flash haute performance NVMe, contournant complètement les protocoles traditionnels de système de fichiers ou de stockage d'objets. En permettant à un groupe entier de GPU de partager instantanément un ensemble commun de contextes d'inférence sans imposer de nouvelles pénalités, ce déploiement permet aux entreprises nord-américaines de réduire considérablement leurs coûts économiques symboliques et d'optimiser les pipelines d'IA à forte densité.
L'Europe constitue un pilier secondaire hautement stable et prévisible pour le marché mondial, entravant une part essentielle de 24 % de la demande totale de l'industrie. Alors que l'expansion nord-américaine est propulsée par un développement agressif à grande échelle de l'IA, l'adoption européenne du stockage des conteneurs est modelée par des réglementations continentales rigides de souveraineté des données comme le RGPD et de nouveaux mandats régionaux d'autonomie numérique. Cette stabilité du marché régional est structurellement isolée par une forte préférence des entreprises pour les configurations de cloud hybride et privé, ce qui permet aux entreprises de maintenir un contrôle strict sur l'endroit où leurs données de conteneurs persistants résident physiquement. Afin d'éviter le verrouillage des fournisseurs et de satisfaire à l'évolution des paramètres de conformité, les groupes informatiques européens investissent régulièrement dans des couches de données de conteneurs-natives à source ouverte, neutres pour les fournisseurs, qui peuvent s'étendre sur des grappes de serveurs localisées disparates.
La région de l'Asie-Pacifique est devenue le territoire qui connaît la croissance la plus rapide à l'échelle mondiale, s'accélérant avec un TCAC de 21,3 %, le plus important marché, pour atteindre une tranche de 21 % des ventes mondiales. Ce changement structurel soudain s'explique par des initiatives massives de transformation numérique soutenues par le gouvernement, des déploiements rapides de réseaux commerciaux 5G et une migration de gros des applications bancaires et de télécommunications vers des environnements de conteneurs. Dans le passé, les entreprises régionales s'appuyaient sur des configurations rigides de disques sur site, mais une explosion soudaine dans les applications mobiles-premier consommateur les a forcés à déployer rapidement des microservices agiles et éphémères qui nécessitent la fourniture instantanée de données locales. Dans l'avenir, le développement futur de l'infrastructure dans ce corridor en plein essor repose fortement sur des architectures de stockage d'objets légères et natives pour capturer et traiter en temps réel la télémétrie IoT industrielle et urbaine de façon abordable.
En mai 2026, les Canonical a officiellement déployé son nouveau cadre léger de Kubernetes MicroK8s, intégrant des couches avancées de moteur de stockage Rook-Ceph distribué directement dans l'architecture du noyau pour gérer les micro-clouds bord. Cette version logicielle permet aux ingénieurs de systèmes de créer des piscines de stockage Kubernetes de qualité de production et très disponibles à travers des nœuds matériels d'entrée de gamme qui reproduisent automatiquement des champs de données d'application vers des environnements de branche localisés sans décalage réseau. En réduisant le volume manuel de friction et en offrant des flux de travail GPU natifs et isolés du matériel, ce déploiement fournit des réseaux de télécommunications et des groupes de détaillants en expansion rapide dans toute l'Asie-Pacifique avec une voie abordable pour les opérations à forte intensité de données au niveau local.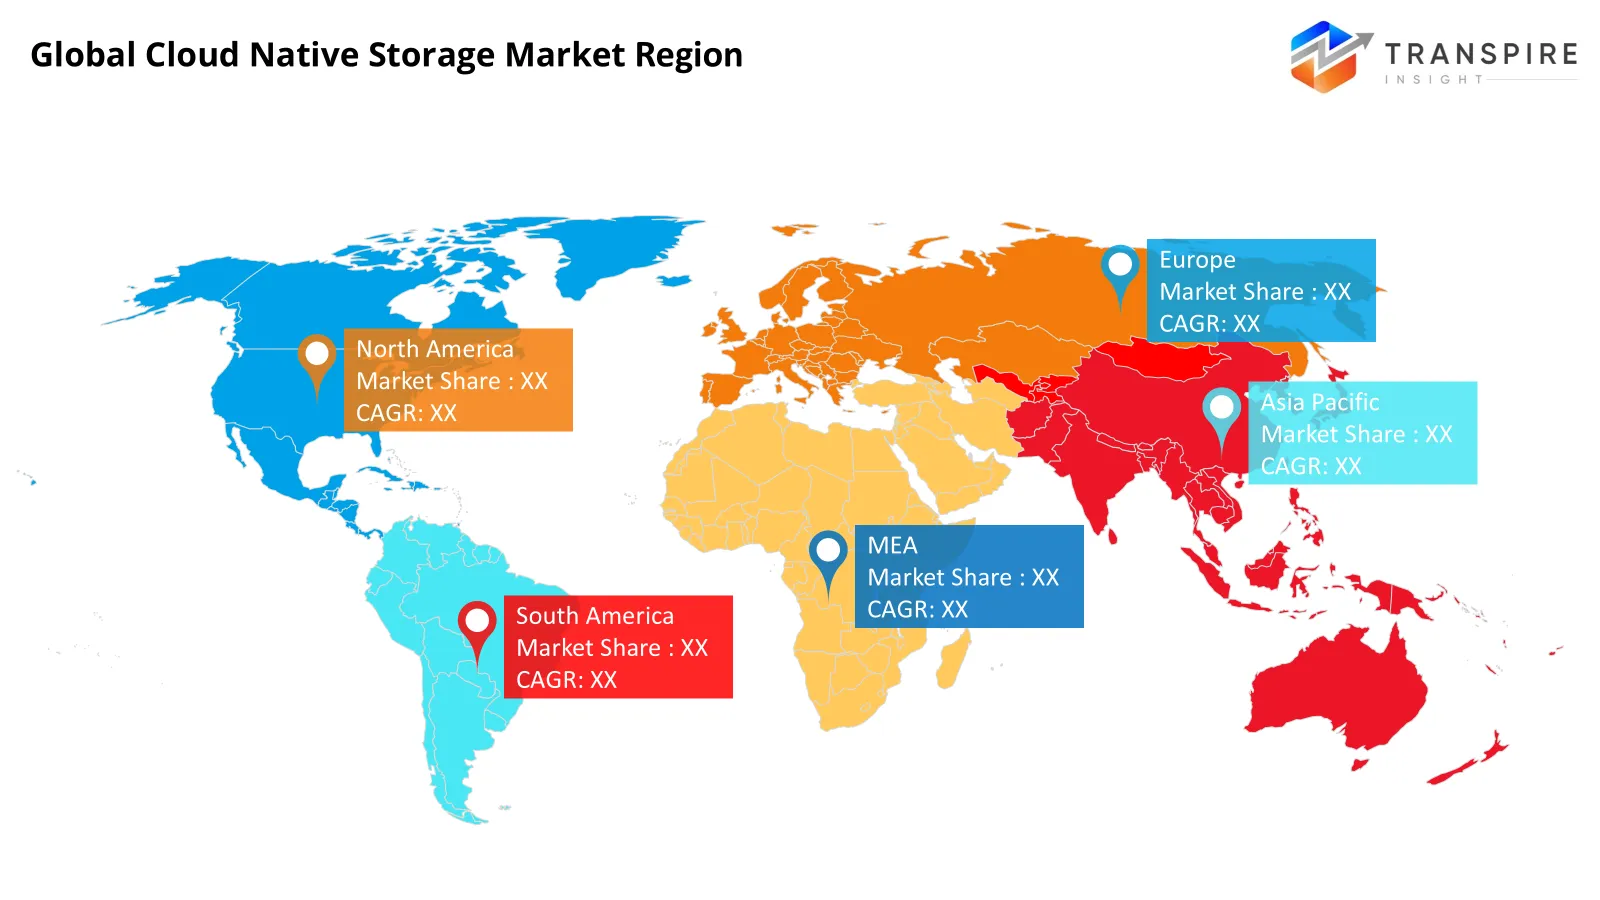
Qui sont les principaux acteurs du Global Marché des Stockage Native Cloud et comment font-ils concurrence
L'espace de stockage natif du cloud mondial est un terrain de bataille entre les géants du stockage d'entreprise classiques et les spécialistes nimbles - définis par les logiciels. Avec des entreprises qui déplacent des piles de bases de données lourdes et des charges de travail d'inférences d'IA en temps réel dans des conteneurs, les fournisseurs se battent sur trois fronts : abaissement de la latence, réduction des frais de données en nuage et garantie que les données peuvent circuler librement entre les nuages sans être verrouillées.
Pure Storage utilise une approche innovante à travers son bras Portworx, se concentrant à la fois sur les applications de conteneurs et les machines virtuelles héritées sous un même toit. Ce qui les distingue, c'est l'intégration serrée de Kubernetes - ce qui donne aux équipes d'ingénierie une mobilité des données à temps zéro, des applications et une synchronisation automatisée des données actives dans les environnements hybrides. Ils grandissent leur empreinte en s'associant aux grandes plateformes d'entreprise comme Red Hat OpenShift pour attraper les entreprises qui tentent d'échapper aux coûts élevés de la virtualisation.
VAST Les données présentent un créneau et une stratégie de haute performance visant carrément les pipelines d'IA massifs et les grappes d'apprentissage profond. Leur architecture unique Disagréguée Shared Everything arrache de vieux systèmes de nivellement de données lents pour fournir des piscines de données massives à l'échelle de l'exaoctet qui offrent des vitesses flash au point de prix des archives bon marché. Ils s'étendent en intégrant leur logiciel directement avec les meilleurs fabricants de puces d'IA et les centres informatiques nationaux pour ancrer les lourdes charges d'apprentissage non-stop.
Liste des entreprises
- NetApp
- Dell Technologies
- Stockage pur
- VMware
- Chapeau rouge
- IBM
- AWS
- Microsoft
- Google Cloud
- Portworx
- UTILISATION
- VAST Données
- Nutanix
- HPE
- Oracle
Développement récent Nouvelles
- En mai 2026, Dell Technologies a officiellement lancé Dell PowerStore Elite, sa plateforme de stockage moderne et intelligente de nouvelle génération. Ce déploiement combine un logiciel d'automatisation intégré à l'IA et une compression assistée par le matériel garantit un équilibre dynamique des charges de travail actives et élimine les frais généraux de fourniture manuelle au sein des réseaux de données hybrides. [https://www.dell.com
Quelles sont les perspectives stratégiques qui définissent l'avenir du Global Marché des Stockage Native Cloud?
Le marché mondial du stockage cloud-natif se dirige vers l'abstraction complète de l'infrastructure, où la couche de stockage sous-jacente devient invisible, et l'hydratation des données se fait dynamiquement en fonction des exigences d'application des conteneurs.
Un risque caché important réside dans la fragmentation des données « CSI sprawl » et multicloud extrême. À mesure que les entreprises font tourner des milliers de grappes de Kubernetes éphémères dans différentes régions du cloud, il devient presque impossible de retrouver et d'obtenir des volumes de données persistants, ce qui entraîne des vulnérabilités de sécurité et des fuites massives de données.
Inversement, une opportunité émergente majeure est la consolidation de machines et de conteneurs virtuels sous des plans de données Kubernetes-natives unifiés utilisant KubeVirt, entraînée par les récentes pressions sur les coûts de licence des plates-formes de virtualisation.
Recommandation stratégique - Les entreprises doivent immédiatement cesser d'acheter des tableaux de matériel siloed et passer à un tissu de stockage open source défini par l'API qui unifie nativement les protocoles de blocs, de fichiers et d'objets sous un seul plan de contrôle Kubernetes pour assurer la portabilité complète des données et la résilience multicloud à zéro temps.
Par composante
- Stockage par blocs
- Stockage des objets
- Stockage des fichiers
- Logiciel
- Services
- Autres
Par déploiement
- Nuage public
- Nuage privé
- Nuage hybride
- Multicloud
- Autres
Par demande
- Conteneurs
- DevOps
- Charges de travail AI
- Gestion des bases de données
- Sauvegarde et récupération
- Autres
Par Utilisateur final
- Télécommunications
- BFSI
- Santé
- Commerce de détail
- Industrie manufacturière
- Autres
Selon la taille de l'organisation
- Grandes entreprises
- PME
- Autres
Perspectives régionales
Amérique du Nord
- États-Unis
- Canada
- Mexique
Europe
- Allemagne
- Royaume-Uni
- France
- Espagne
- Italie
- Reste de l'Europe
Asie-Pacifique
- Japon
- Chine
- Australie et Nouvelle-Zélande
- Corée du Sud
- Inde
- Reste de l ' Asie et du Pacifique
Amérique du Sud
- Brésil
- Argentine
- Reste de l'Amérique du Sud
Moyen-Orient et Afrique
- Arabie saoudite
- Émirats arabes unis
- Afrique du Sud
- Reste du Moyen-Orient & Afrique
Foire aux questions
Trouvez des réponses rapides aux questions les plus courantes.
La taille du marché mondial du stockage natif des nuages a été évaluée à 19,3 milliards de dollars en 2025 et devrait atteindre 99,7 milliards de dollars d\'ici 2033, soit une augmentation de 22,71% du TCAC.\n.
Les principaux segments du marché mondial du stockage natif du cloud sont les composants (logiciel, stockage d\'objets, stockage de fichiers, logiciels, services, autres); Par déploiement (nuage public, cloud privé, cloud hybride, multicloud, autres); Par application (conteneurs, DevOps, charge de travail AI, gestion de base de données, sauvegarde et récupération, autres); Par utilisateur final (IT & Telecom, BFSI, soins de santé, vente au détail, fabrication, autres); Par taille de l\'organisation (grandes entreprises, PME, autres).
La croissance est principalement due à la transition massive des microservices apatrides vers des applications containerizzato d\'état à l\'intérieur de Kubernetes, ce qui crée un besoin urgent de structures de stockage basées sur l\'API et alimentées dynamiquement qui éliminent le décalage de performance et les silos de données.\n.
Le marché mondial est dirigé par de grands fabricants dont NetApp, Dell Technologies, Pure Storage, VMware, Red Hat, IBM, AWS, Microsoft, Google Cloud, Portworx, SUSE, VAST Data, Nutanix, HPE et Oracle.\n.
L\'Amérique du Nord détient une part dominante de 47 % du chiffre d\'affaires mondial, une dynamique industrielle fortement façonnée en raison de son réseau dense de centres de données hyperscalaires, de capitaux institutionnels massifs entrant dans des cadres avancés d\'intelligence artificielle et d\'un écosystème très mature d\'équipes d\'ingénierie de Kubernetes.\n.
Des opportunités commerciales de grande valeur existent dans le déploiement d\'architectures légères de stockage d\'objets de conteneur-natif à haut débit optimisées spécifiquement pour le traitement des données locales au bord du réseau et la construction de moteurs de stockage vectoriel dédiés et persistants pour ancrer des boucles d\'inférence AI en temps réel.\n.
- NetApp
- Dell Technologies
- Stockage pur
- VMware
- Chapeau rouge
- IBM
- AWS
- Microsoft
- Google Cloud
- Portworx
- UTILISATION
- VAST Données
- Nutanix
- HPE
- Oracle
About the Authors

Mayur Shinde
I am Mayur Shinde, a Senior Research Analyst at Transpire Insight, specializing in the Automotive & Transportation and Information & Communication Technology (ICT) Industry. My work focuses on analyzing emerging market trends, technological advancements, competitive landscapes, and industry developments to deliver accurate, data-driven insights. I am passionate about transforming complex market information into clear, actionable content that helps businesses, professionals, and decision-makers stay informed and make confident strategic decisions.

Chakradhar Khansole
Chakradhar serves as the Research Director at Transpire Insight, bringing over 8 years of experience in technology, innovation, and strategic market intelligence. He specializes in transforming complex market data into actionable business insights that enable organizations to make informed, growth-oriented decisions. Recognized for his strategic vision and analytical expertise, Chakradhar leads high-impact research initiatives, delivering comprehensive market assessments, competitive intelligence, and forward-looking industry analysis.
Rapports récemment publiés
-
Apr 2026
Marché des Profileur optique 3D
3d profileur optique taille du marché, rapport de part et d'analyse par type (desktop 3d profileur optique, et portable 3d profileur optique), par technologie (technologie confocale, et interférence de la lumière blanche), par industrie d'utilisation finale (industrie manufacturière, instituts de recherche, automobile, aérospatiale et défense, dispositifs médicaux, etc.), et géographie (amérique du nord, europe, asie-pacifique, moyen-orient et afrique, amérique du sud et centre), 2021 - 2031
-
Apr 2026
Marché des Capteur de profondeur
rapport d'analyse par type (capteurs de profondeur infrarouge, capteurs de temps de vol, capteurs de vision stéréo, capteurs de lumière structurés, capteurs de profondeur ultrasoniques), par application (automotive, robotique, jeu, électronique grand public, automatisation industrielle, soins de santé, sécurité et surveillance, autres), par les utilisateurs finaux (fabricants d'automobiles, entreprises d'électronique grand public, fournisseurs de soins de santé, entreprises industrielles, agences de sécurité, compagnies de jeux, entreprises de robotique, autres), et géographique (amérique du nord, europe, asie-pacifique, moyen-orient et afrique, amérique du sud et centre), 2021 – 2031
-
Apr 2026
Marché des Fabrication numérique
taille du marché de la fabrication numérique, rapport de part et d'analyse par composante (matériel, logiciel et services), par technologie (robotique, impression 3d, internet des objets (iot), etc.), par application (automobile et transport, aérospatiale et défense, électronique grand public, machines industrielles, etc.), par type de processus (conception par ordinateur, simulation par ordinateur, visualisation 3d, analyse, etc.), et géographie (amérique du nord, europe, asie-pacifique, moyen-orient et afrique, amérique du sud et amérique centrale), 2021 – 2031
-
Apr 2026
Marché des Services de visas numériques
services de visa numérique taille du marché, part et rapport d'analyse par type (voyageurs individuels, voyageurs de groupe), par demande (tourisme, voyage d'affaires, autres), et géographie (amérique du nord, europe, asie-pacifique, moyen-orient et afrique, amérique du sud et centre), 2021 – 2031