
Marché des Outils d'annotation des données Résumé:
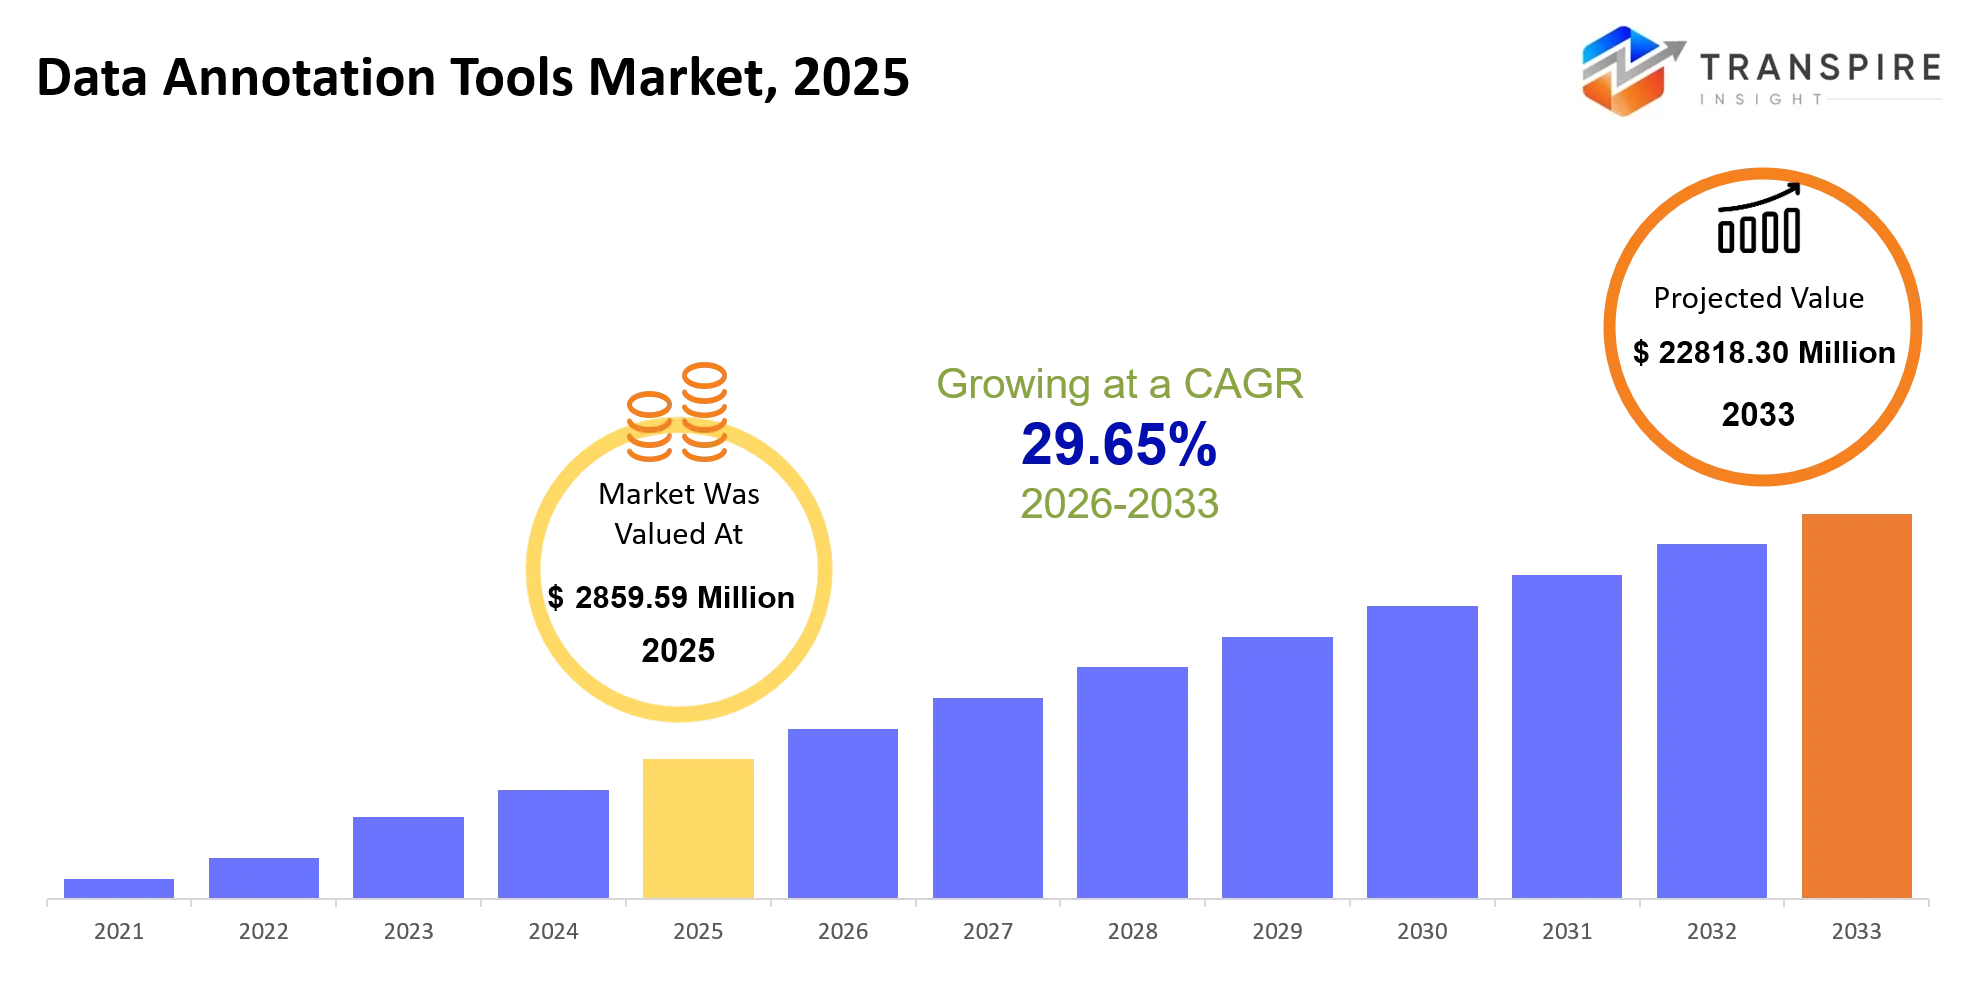
Selon l'analyse Transpire Insight, le Marché des Outils d'annotation des données est estimé à 2859,59 millions de dollars en 2025 et devrait atteindre 22818,30 millions de dollars d'ici 2033, avec une croissance de 29,65% entre 2026 et 2033..
Les outils d'annotation des données Le marché passe de l'exploitation de données de niveau inférieur à l'exploitation de données de niveau plus bas, grâce à l'automatisation, qui organisent des ensembles de données pour les modèles afin d'apprendre, de tester et de gouverner. Au cours des trois à cinq dernières années, les outils d'annotation sont passés de l'étiquetage des images à de vastes flux de travail vidéo, texte, audio, 3D, capteur et SIG; le préétiquetage automatisé et l'examen humain ont simplifié les tâches répétitives et ennuyeuses. Un changement de conception, selon les experts, est vers l'annotation hybride; les modèles produisent des étiquettes qui sont ensuite prouvées et vérifiées par l'expert Annotators plutôt que de se fier uniquement à l'équipage pour construire des étiquettes. Les allumeurs du monde réel comprennent le large déploiement de l'IA génératrice, des véhicules autonomes, de la robotique et de la vision informatique qui a augmenté le volume de données et la charge de travail d'annotation. En outre, des réglementations supplémentaires ont renforcé la valeur des processus de traçabilité; la loi sur l'IA de l'UE renforce la transparence et impose des documents détaillés pour les données de formation, et les outils d'annotation au début améliorent la qualité des données, l'auditabilité et l'itération.
Marché des Outils d'annotation des données Taille et prévisions :
- Taille du marché 2025 : 2859,59 millions de dollars
- Valeur marchande prévue (2033): USD 22818.30 Millions
- Prévisions CAGR (2026-2033): 29,65 %
- Région phare en 2025 : Amérique du Nord
- Région en pleine croissance : Asie-Pacifique
- Profils clés de l'entreprise : Scale AI, Appen, TELUS International, Labelbox, SuperAnnotate, Encord, Sama, iMerit, CloudFactory, Label Studio, V7, Dataloop, Hive, CVAT, Amazon Web Services
Key Marché des Outils d'annotation des données Insights:
Le marché passe de l'étiquetage à forte intensité de main-d'oeuvre à l'étiquetage assisté par l'IA, validé par l'homme. données les opérations et la charge de travail multimodale et physique de l'IA gagnent en importance. La capacité d'annoter directement les flux de travail avec les connaissances du domaine, la traçabilité et la capacité de se connecter à l'évaluation et au déploiement des modèles devient un élément clé de l'avantage concurrentiel.
- Échelle AI, Appen et TELUS À l'échelle internationale, l'annotation de l'image est améliorée de 42 %, ce qui réduit l'effort manuel avec des boucles de pré-étiquetage et d'apprentissage actif assistées par modèle.
- L'annotation vidéo à 18% devient plus populaire dans l'utilisation d'entreprise, avec Labelbox, SuperAnnotate et Encord outils qui incorporent l'aspect chronologique de l'annotation pour l'ADAS, la robotique et l'analyse de détail.
- À 14 %, l'annotation textuelle est en train de changer avec l'IA générative, avec Hive, V7 et Dataloop introduisant la suggestion de portée basée sur la LLM et l'étiquetage de préférence RLHF.
- La technologie audio et les flux de travail de la parole sont en cours de transition vers la diarisation et la transcription semi-automatisées à l'aide de Sama, iMerit et CloudFactory pour les applications de centres de contact et de soins de santé.
- Encord, CVAT et Label Studio lancent respectivement LiDAR et des éditeurs point-cloud pour la conduite autonome et la robotique industrielle, et sont à l'origine de la croissance de l'annotation 3D à 7%.
- Les joueurs de Niche se joignent aux données de capteurs (5 %) et aux données géospatiales (3 %) pour combiner des données multimodales pour l'agriculture, l'infrastructure et la cartographie de la défense.
- Sur le plan des composants, des outils et des plateformes, AWS, Label Studio et Dataloop se lancent dans les API, les services gérés et l'intégration avec les piles MLOps.
- Les technologies de la vision informatique, du NLP et de l'apprentissage profond sont toujours centrales, et l'IA et la robotique génératrices deviennent un différenciateur pour le pré-étiquetage et les données synthétiques.
- Les véhicules autonomes et les soins de santé sont à l'avant-garde, suivis de la vente au détail, de la sécurité, de la fabrication et de l'informatique et des télécommunications, en termes d'application de l'annotation, qui sera utilisée dans le cadre du recyclage en cours.
Quels sont les moteurs clés, les restrictions et les possibilités du Marché des outils d'annotation des données?
Conducteur :
L'IA et le développement de modèles multimodaux font passer l'annotation au-delà du simple étiquetage de l'image. Les modèles de fondation, la robotique, les systèmes autonomes et l'évaluation de l'IA nécessitent des ensembles de données texte, vidéo, audio, 3D et capteurs bien étiquetés. À mesure que la complexité des données augmente, les organisations adoptent des plateformes d'annotation intégrées qui combinent l'étiquetage, le contrôle de la qualité et la gestion des flux de travail. Ce changement accroît l'adoption de logiciels tout en créant des possibilités de revenus récurrents grâce à des services gérés, à l'automatisation et à des opérations de données spécialisées.
3.1.2 Retenue:
La qualité de l'annotation demeure difficile à normaliser entre les langues, les domaines et les applications à haut risque. La question structurelle est que les étiquettes automatisées peuvent reproduire des erreurs de modèle, manquer de contexte subtil, ou encoder des instructions incohérentes, forçant l'examen humain, les contrôles de qualité et la supervision spécialisée. Cela augmente les coûts de main-d'oeuvre, de gouvernance, d'intégration et de validation et peut ralentir le déploiement.
Possibilité :
Les flux de travail assistés par l'IA et les données synthétiques peuvent réduire l'étiquetage répétitif tout en élargissant la couverture des scénarios rares. AWS Clean Rooms prend en charge des ensembles de données synthétiques améliorant la vie privée pour la formation en ML, démontrant comment les organisations peuvent créer des données de formation utilisables sans exposer les enregistrements originaux. Combinés à l'apprentissage actif, au pointage de confiance et à l'examen humain en boucle, ces capacités peuvent ouvrir de nouvelles adoptions dans les domaines des soins de santé, de l'automobile, de la robotique, des services financiers et de l'IA des entreprises réglementées. Les fournisseurs peuvent également monétiser l'assurance de la qualité, l'expertise du domaine et les flux de travail de conformité à mesure que les clients passent de projets ponctuels à des opérations de données régulées et répétables.
Quel est l'impact de l'intelligence artificielle sur le Marché des outils d'annotation des données?
Les outils d'annotation améliorés par l'IA transforment les plates-formes d'annotation des systèmes de gestion des tâches en écosystèmes adaptatifs de production de données. Les modèles ML peuvent pré-annoter des images, des vidéos et des données de capteur en streaming; la vision informatique peut détecter des limites d'objets et des annotations de métadonnées, que les humains peuvent alors vérifier; les modèles NLP peuvent trier des documents, auto-identifier des entités et suggérer des étiquettes de phrases pour réduire le travail répétitif; les flux de travail actifs d'apprentissage peuvent concentrer l'effort humain sur des points de données de grande valeur; les contrôles de qualité prédictifs peuvent identifier des erreurs potentielles, prévoir des ensembles de données potentiellement litigieux et déclencher des alarmes en cas de contamination potentielle des ensembles de données; et l'IA générative peut créer des données synthétiques pour augmenter les efforts humains dans les expansions de scénarios ou les collections d'événements rares. En termes d'opérations, il réduit le temps d'annotation, augmente le débit et soutient la surveillance continue de la qualité. Des experts humains et la validation de la vérité au sol sont encore nécessaires de plusieurs façons : identifier les lacunes en matière de précision, résoudre les ambiguïtés dans les domaines spécialisés, assurer une intégration compatible avec les flux de données existants et les coûts de validation des étiquettes générées par l'IA. Human-in-the-loop est la direction de la croissance pour les marchés d'annotation.
En septembre 2026, SuperAnnotate a obtenu un financement de la série B de 36 millions de dollars. Ce soutien financier a été dirigé par Socium Ventures avec la participation des principaux leaders de l'infrastructure AI, dont NVIDIA et Databricks Ventures.https://techcrunch.com/2024/11/18/superannotate-helps-companies-manage-their-ai-data-sets/
Key Marché des Outils d'annotation des données Tendances
Le passage de l'étiquetage manuel à des flux de travail assistés par l'IA, multimodaux et prêts à la gouvernance dans le domaine de l'annotation. Les acheteurs apprécient les outils qui relient l'étiquetage, le contrôle de la qualité, les données synthétiques, l'évaluation et les pistes de vérification plutôt que les caractéristiques d'annotation individuelle.
- Les processus manuels sont remplacés par le préétiquetage, et les humains traitent des exceptions et des cas difficiles.
- L'IA pour les projets physiques passe de l'image à la vidéo, la 3D, le capteur et les ensembles de données multimodales.
- La transition de la production en volume à l'expertise du domaine est en cours, avec des équipes d'annotation axées sur les soins de santé, la robotique et l'IA réglementée.
- L'apprentissage actif est le processus consistant à passer de l'annotation à l'échantillonnage fondé sur l'incertitude, ce qui réduit le nombre d'exemples de faible valeur.
- Les données synthétiques apparaissent comme une alternative aux données du monde réel lorsque la confidentialité, la rareté ou les restrictions de sécurité empêchent la collecte de données du monde réel.
- Le contrôle de la qualité évolue pour devenir un examen continu et ciblé fondé sur les signaux de désaccord et de confiance du modèle.
- Les acheteurs d'entreprise cherchent à combiner les labels, la gestion des effectifs, l'évaluation et la gouvernance en une seule plateforme.
- On met de plus en plus l'accent sur la surveillance réglementaire des processus, de la documentation et de la surveillance humaine contrôlée des données de formation.
- L'évaluation de l'acheteur passe de la vitesse d'annotation à la précision, à la cohérence et à la performance du modèle.
- À mesure que l'IA s'étend aux régions, aux règlements et au jargon propre à l'industrie, l'annotation multilingue et spécialisée devient de plus en plus importante. Cela donne un avantage aux fournisseurs qui peuvent lier l'étiquetage à l'évaluation et à la rétroaction.
Marché des Outils d'annotation des données Segmentation
Par composante :
Les outils forment la couche opérationnelle de base pour créer, gérer et valider des ensembles de données étiquetés, tandis que les services soutiennent les exigences d'annotation spécialisée. Les plateformes gagnent en importance en connectant l'étiquetage à la gestion des données et aux flux de travail des modèles. Les API permettent l'intégration avec les pipelines d'IA existants, tandis que les services gérés, le conseil et l'intégration répondent aux besoins de mise en œuvre et de gouvernance de l'entreprise. D'autres captent les nouvelles capacités de flux de travail, permettant aux organisations de combiner l'annotation et les processus d'assurance de la qualité, d'évaluation et de déploiement.
Par type d'annotation:
L'image mène à 42%, soutenue par la vision informatique, l'inspection, la reconnaissance d'objets et la charge de travail visuelle de contrôle de la qualité dans toutes les industries. La vidéo compte pour 18 %, ce qui reflète l'utilisation croissante des systèmes autonomes, de la surveillance et de l'analyse comportementale, tandis que Text détient 14 %, sous l'impulsion du traitement de documents, du NLP et de la formation générale sur l'IA. L'audio représente 8 %, suivi de la 3D à 7 %, des données de capteur à 5 %, de la géospatiale à 3 % et d'autres à 3 %. Ce mélange met en évidence le passage du marché à l'annotation multimodale, où les organisations combinent l'image, la vidéo, la langue, l'espace et les ensembles de données de capteurs pour améliorer la précision des modèles d'IA, la compréhension contextuelle et les performances de déploiement.
Par technologie :
L'apprentissage automatique, la vision informatique, le NLP, la reconnaissance de la parole, l'apprentissage profond, l'IA generative, la robotique et d'autres fonctionnent de plus en plus ensemble à travers les flux de travail d'annotation. L'apprentissage automatique et la vision informatique automatisent le pré-étiquetage, tandis que les technologies NLP et de la parole supportent le traitement du texte et de l'audio. L'IA génératrice développe les capacités de données synthétiques et d'évaluation, tandis que la robotique augmente les besoins en ensembles de données spatiales. L'annotation 3D enregistre un TCAC de 26,1%, soutenu par la robotique et l'adoption spatiale de l'IA.
Par demande :
Les véhicules autonomes et les soins de santé représentent des cas d'utilisation importants, nécessitant des ensembles de données de haute qualité pour la perception, le diagnostic, la classification et l'évaluation des modèles. Le commerce de détail applique l'annotation à la reconnaissance des produits, à l'analyse des clients et à l'intelligence visuelle, tandis que la sécurité utilise des données vidéo et d'image étiquetées pour les systèmes de détection. L'agriculture applique la vision informatique à la surveillance des cultures et des champs, tandis que la fabrication, l'informatique et les télécommunications, entre autres, utilisent l'annotation pour l'inspection, l'automatisation, le traitement des documents et l'amélioration continue des modèles d'IA.
Par l'approche de l'annotation :
L'annotation manuelle demeure importante lorsque les ensembles de données nécessitent un jugement contextuel, des connaissances spécialisées ou un étiquetage complexe. Les approches semi-supervisées et automatisées sont adoptées en utilisant des étiquettes produites par la machine pour réduire le travail répétitif avant la validation humaine. Les modèles externalisés et crowdsourced fournissent une capacité de main-d'oeuvre flexible, tandis que les approches internes offrent un meilleur contrôle sur les ensembles de données sensibles. Les flux de travail hybrides combinent de plus en plus ces méthodes, aidant les entreprises à équilibrer la vitesse d'annotation, la précision, la gouvernance et les coûts opérationnels.
Par taille d'entreprise :
Les grandes entreprises ancrent les dépenses parce qu'elles gèrent de vastes programmes d'IA exigeant une infrastructure, une sécurité et une gouvernance évolutives. Les PME et les startups adoptent des outils basés sur le cloud qui réduisent les besoins technologiques initiaux et offrent un accès souple aux capacités d'annotation. Les organisations gouvernementales exigent des ensembles de données contrôlés et traçables pour les applications d'IA du secteur public, tandis que les instituts de recherche, les entreprises technologiques et les institutions universitaires génèrent des projets spécialisés impliquant des ensembles de données d'IA scientifiques, expérimentales, multilingues et émergentes.
Par Utilisateur final :
Automobile et santé génèrent des exigences d'annotation substantielles grâce à la conduite autonome, l'imagerie médicale et les applications cliniques d'IA. Le commerce de détail utilise des données étiquetées pour la recherche visuelle, la personnalisation et l'intelligence de l'inventaire, tandis que BFSI applique l'annotation aux documents, aux interactions avec les clients et aux flux de risques. La fabrication et les médias utilisent de plus en plus des ensembles de données multimodales pour l'automatisation et l'intelligence du contenu. Le gouvernement et d'autres intervenants mettent l'accent sur la sécurité, la traçabilité, l'exactitude des domaines et le traitement contrôlé des données à mesure que l'adoption de l'IA s'étend.
Quels sont les cas d'utilisation clé conduisant le Marché des Outils d'annotation des données?
L'annotation de l'image domine, représentant 42 % des revenus du segment, en raison de l'adoption généralisée de la vision informatique par le segment. L'annotation pour l'inspection, la reconnaissance d'objets, l'imagerie médicale, la connaissance de la situation au détail et la détection des conditions routières existe dans toutes les industries, à l'aide de boîtes de délimitation, de polygones, de classification et de segmentation pour permettre l'utilisation des cas.
Les marchés et les services gérés étendent les cas d'utilisation de base aux données vidéo, texte, audio, 3D et capteurs, à mesure que les systèmes d'IA deviennent multimodaux. L'automobile et la robotique combinent la caméra, le lidar et les annotations de capteurs, tandis que les soins de santé et le BFSI étendent l'annotation de texte et de document à l'extraction de l'information, à la classification et à la validation des modèles de données.
Les nouveaux cas d'utilisation se concentrent sur les ensembles de données de rétroaction humaine pour l'IA générative, les tests de sécurité, la validation de données synthétiques et l'entraînement physique-AI. Ces flux de travail conduisent à la demande de séries de données spécifiques à un scénario, à l'examen d'experts, à la traçabilité et aux annotations de couverture, où le crowdsourcing ne peut pas combler l'écart.
| Statistiques | Détails |
| Valeur de la taille du marché en 2025 | USD 2859.59 Millions |
| Valeur de la taille du marché en 2026 | 3706,60 millions de dollars |
| Prévisions de recettes en 2033 | USD 22818,30 Millions |
| Taux de croissance | TCAC de 29,65 % de 2026 à 2033 |
| Année de référence | 2025 |
| Données historiques | 2021 - 2024 |
| Période de prévision | 2026 - 2033 |
| Couverture du rapport | Prévisions de revenus, contexte concurrentiel, facteurs de croissance et tendances |
| Portée régionale | Allemagne, États-Unis, Canada, Mexique, Royaume-Uni, Espagne, France, Italie, Danemark, Suède, Norvège, Chine, Japon, Inde, Australie, Corée du Sud, Thaïlande, Brésil, Argentine, Afrique du Sud, Émirats arabes unis |
| Principales entreprises | Scale AI, Appen, TELUS International, Labelbox, SuperAnnotate, Encord, Sama, iMerit, CloudFactory, Label Studio, V7, Dataloop, Hive, CVAT, Amazon Web Services. |
| Portée de la personnalisation | Personnalisation gratuite des rapports (pays, région et segment). Options d'achat sur mesure disponibles pour répondre à vos besoins de recherche exacts. |
| Segmentation du rapport | Par composante (outils, services, plateformes, API, services gérés, conseil, intégration, autres); Par type d'annotation (image, vidéo, texte, audio, 3D, données de capteurs, géospatiales, autres); Par technologie (apprentissage de la machine, vision informatique, NLP, reconnaissance de la parole, apprentissage profond, intelligence génétique, robotique, autres); Par application (véhicules automobiles, soins de santé, vente au détail, sécurité, agriculture, fabrication, TI et télécommunications, autres); Par approche d'annotation (manuel, semi-supervisé, automatisé, externalisé, crowdsourced, interne, hybride, autres); Par taille d'entreprise (grandes entreprises, PME, startups, gouvernement, instituts de recherche, entreprises technologiques, établissements universitaires, autres); Par utilisateur final (automobile, santé, vente au détail, BFSI, fabrication, médias, gouvernement, autres) |
Quelles régions conduisent le Marché des Outils d'annotation des données ?
L'Amérique du Nord prend la tête à 43 %, car la plupart des concepteurs de modèles d'IA, des programmes de véhicules autonomes et des grands fournisseurs de cloud qui ont besoin de données constantes et de qualité sont basés ici. L'écosystème nord-américain de l'infrastructure haut de gamme, du financement de projets robuste et de l'adoption précoce de l'IA crée un cycle qui se nourrit de lui-même – la demande de plateformes d'annotation plus avancées. Une réglementation accrue sur la façon dont les données peuvent être utilisées dans plusieurs industries, et des partenaires d'impartition matures, aident à consolider ce leadership – un cercle vertueux qui donne lieu à de meilleurs modèles exigeant des dépenses d'annotation plus élevées.
- En février 2026, Labelbox a acquis la startup d'automatisation des ventes mandataires Upcraft. Cette intégration intègre la technologie d'agent d'IA d'Upcraft dans l'infrastructure de Labelbox pour automatiser les flux de travail et étendre rapidement la portée de son réseau de plus d'un million d'experts du domaine.https://www.prnewswire.com/news-releases/labelbox-acquires-agentic-sales-automation-startup-upcraft-to-rapidly-scale-the-human-expertise-powering-frontière-ai-302684445.html
- L'Europe à 27 % maintient une croissance constante, avec des secteurs de l'automobile, de la fabrication industrielle et de la santé matures bénéficiant d'une forte précision, d'une annotation de conformité élevée avec une connaissance approfondie de l'industrie. Toutefois, la croissance est plus modeste qu'en Amérique du Nord, limitée par les règles propres au marché et le RGPD. Ces réglementations sous-tendent la demande de processus d'annotation sur site ou dans le nuage souverain axés sur la qualité au lieu d'une simple échelle, ce qui nécessite des investissements plus importants dans les outils de regtech et la croissance à long terme.
- En janvier 2026, Amazon Web Services (AWS) a lancé le Cloud Souverain européen AWS. Cette initiative d'infrastructure spécialisée est soutenue par une première région indépendante en Allemagne.https://press.aboutamazon.com/aws/2026/1/aws-launches-aws-european-sovereign-cloud-and-announces-expansion-cross-europe
- L'Asie-Pacifique représente 22 % du marché et connaît une croissance de 25,4 %; le marché qui connaît la croissance la plus rapide, alors que les programmes de systèmes d'IA en Inde, en Chine, au Japon et en Asie du Sud-Est s'accélèrent rapidement en même temps que la main-d'oeuvre devient plus compétitive sur le plan des coûts. Une tendance récente a été l'augmentation de la capacité locale d'intelligence artificielle et une proportion plus élevée des travaux d'annotation sont détournés vers la région. À l'avenir, l'occasion est de développer des plateformes adaptées localement et conformes pour les entreprises nationales et internationales à la recherche d'échelle et de vitesse.
- En mai 2026, Google Cloud a annoncé des collaborations élargies avec Enterprise Singapore, Komdigi d'Indonésie, NIC du Vietnam et SIHUB de Ho Chi Minh City pour lancer un corridor d'innovation de démarrage AI.https://www.googlecloudpresscorner.com/Google-Cloud-Launches-AI-Startup-Innovation-Corridor-du-Sud-Est-Asie-à-Silicon-Valley-avec-EntrepriseSG-Kommigi-NIC-et-SIHUB
Qui sont les principaux acteurs du Marché des Outils d'annotation des données, et comment sont-ils en compétition ?
La concurrence sur le marché s'échauffe au niveau des outils d'annotation du jeu pur, car les fournisseurs de services et les hyperscaleurs combinent plate-forme, connaissances spécialisées du domaine et fourniture à grande échelle pour l'accès au marché. Les acteurs établis comme Scale AI, Appen et TELUS International différencient sur l'échelle, la profondeur du domaine et les opérations de données de bout en bout avec l'examen humain en boucle pour les véhicules autonomes, NLP et l'IA d'entreprise. Pendant ce temps, les nouveaux venus de la catégorie se spécialisent dans les modalités de niche ou les verticales, mettant l'accent sur l'innovation et les outils d'annotation favorables aux développeurs avec l'étiquetage assisté par modèle, l'apprentissage actif et les API de plate-forme ouverte, comme Labelbox, Super Annotate et Encord. Enfin, des entreprises comme Sama, iMerit et Cloud Factory se concentrent sur l'externalisation rentable et socialement responsable des opérations d'annotation à grande échelle avec des équipes dédiées aux soins de santé, la modération du contenu d'entreprise, et des tâches de vision informatique difficiles. Les stratégies Niche et open-source sont poursuivies par Label Studio, V7, Dataloop, Hive et CVAT, offrant des plates-formes flexibles et adaptables qui peuvent être intégrées dans des pipelines de recherche personnalisés; la stratégie de verrouillage écosystémique de Microsoft domine l'espace de plate-forme d'annotation basé sur le cloud en intégrant étroitement l'annotation dans ses services étendus d'IA et de cloud, ce qui facilite l'adoption par les grandes entreprises clientes par l'acquisition et l'intégration du cloud et de la plate-forme.
Les joueurs clés sont :
- Échelle AI
- Appen
- TELUS International
- Boîte à étiquettes
- SuperAnnoter
- Enregistrement
- Sama
- IMerit
- CloudFactory
- Étiquette Studio
- V7
- Dataloop
- Vive
- TVA
- Services Web Amazon
Développement récent Nouvelles
- En mars 2026, Universal Robots s'est associé à Scale AI pour lancer le système d'apprentissage d'imitation UR AI Trainer au GTC 2026. Cette collaboration permet de recueillir des données synchronisées sur le mouvement, la force et la visibilité du matériel industriel afin de combler l'écart entre le laboratoire et l'usine pour la formation des modèles de base en robotique.http://universal-robots.com/news-and-media/news-center/universal-robots-scale-ai-lancement-imitation-apprentissage-système-accélération-ai-formation-lab-à-usine/
- En avril 2026, Quhuo s'est associé à Wons pour établir des opérations conjointes de services de données AI en Chine, au Vietnam, en Allemagne et aux États-Unis. Le partenariat combine les normes d'annotation Wons et les systèmes de qualité avec les capacités de la main-d'oeuvre de Quhuo pour la collecte de données, l'annotation, le nettoyage et l'inspection de la qualité à travers les ensembles de données image, audio, texte et point-cloud.https://www.prnewswire.com/news-releases/quhuo-partners-wons-to-expand-ai-data-collect-and-training-services-broadening-international-reach-302754107.html
- En mars 2026, Centific a lancé Data Canvas, un système d'exploitation d'annotation conçu pour l'IA physique, la robotique, l'IA incarnée et les systèmes autonomes. Le produit ajoute la fusion de données multi-capteurs et l'étiquetage de raisonnement-traçable, en élargissant les capacités d'annotation pour des flux de formation multimodaux complexes.https://www.centific.com/blog/centific-launches-data-canvas-the-first-annotation-product-built-for-physical-ai
Quelles sont les perspectives stratégiques qui définissent l'avenir du Marché des Outils d'annotation des données?
Le marché va dans le sens de l'exploitation des données de l'IA-native, où l'annotation, l'évaluation, la production de données synthétiques, le contrôle de la qualité et la rétroaction des modèles sont tous contenus dans un processus continu. Le risque invisible est que l'automatisation puisse refléter l'échelle des fausses étiquettes tout aussi facilement que les vraies, rendant la validation experte et la gouvernance de l'ensemble de données de plus en plus stratégique plutôt qu'un « bon à avoir ». Les pressions réglementaires en matière de conformité - y compris la future loi de l'UE sur l'IA, qui imposera des exigences en matière de transparence et de documentation aux systèmes d'IA - ne font qu'accroître la responsabilité. Une possibilité supplémentaire en matière d'IA physique dans la robotique, les véhicules autonomes, le LiDAR, la fusion de capteurs et les ensembles de données sur le comportement humain nécessite une annotation spécifique au domaine qui diffère de l'étiquetage d'image et de texte utilisé dans les données natives d'AI. L'investissement de 2026 d'Encord dans une infrastructure de données autochtones sur l'IA et l'incursion de TELUS Digital dans les services de données physiques sur l'AI illustrent cette nouvelle orientation. La stratégie des fournisseurs devrait passer à l'orchestration multimodale, à la validation par domaine, à la provenance et à des flux de travail réutilisables assistés par l'IA, plutôt qu'à l'ajout de nouveaux arrivants à la capacité du personnel d'annotation.
Les principales segmentations sont les suivantes:
Par composante
- Outils
- Services
- Plateformes
- API
- Services gérés
- Conseil
- Intégration
- Autres
Par type d'annotation
- Image
- Vidéo
- Texte
- Audio
- 3D
- Données du capteur
- géospatial
- Autres
Par technologie
- Apprentissage automatique
- Vision informatique
- NLP
- Reconnaissance du discours
- Enseignement approfondi
- IA générique
- Robotique
- Autres
Par demande
- Véhicules autonomes
- Santé
- Commerce de détail
- Sécurité
- Agriculture
- Industrie manufacturière
- Télécommunications
- Autres
Par une approche d'annotation
- Manuel
- Semi-supervisé
- Automatisation
- externalisé
- Source brute
- En interne
- Hybride
- Autres
Taille de l'entreprise
- Grandes entreprises
- PME
- Créations
- Gouvernement
- Instituts de recherche
- Entreprises de technologie
- Établissements universitaires
- Autres
Par Utilisateur final - Automobile
- Santé
- Commerce de détail
- BFSI
- Industrie manufacturière
- Médias
- Gouvernement
- Autres
Analyse régionale
Amérique du Nord
- États-Unis
- Canada
- Mexique
Europe
- Allemagne
- Royaume Uni
- France
- Italie
- Espagne
- Russie
- Reste de l'Europe
Asie-Pacifique
- Chine
- Japon
- Inde
- Corée du Sud
- Australie
- Reste de l ' Asie et du Pacifique
Amérique du Sud
- Brésil
- Argentine
- Reste de l'Amérique du Sud
Moyen-Orient et Afrique
- EAU
- Arabie saoudite
- Qatar
- Afrique du Sud
- Reste du Moyen-Orient & Afrique
Foire aux questions
Trouvez des réponses rapides aux questions les plus courantes.
The data annotation tools market size was valued at USD 2859.59 million in 2025 and is poised to reach USD 22818.30 million by 2033, expanding at a 29.65% CAGR.
Key segments for the data annotation tools market are By Component (Tools, Services, Platforms, APIs, Managed Services, Consulting, Integration, Others); By Annotation Type (Image, Video, Text, Audio, 3D, Sensor Data, Geospatial, Others); By Technology (Machine Learning, Computer Vision, NLP, Speech Recognition, Deep Learning, Generative AI, Robotics, Others); By Application (Autonomous Vehicles, Healthcare, Retail, Security, Agriculture, Manufacturing, IT & Telecom, Others); By Annotation Approach (Manual, Semi-supervised, Automated, Outsourced, Crowdsourced, In-house, Hybrid, Others); By Enterprise Size (Large Enterprises, SMEs, Startups, Government, Research Institutes, Technology Companies, Academic Institutions, Others); By End User (Automotive, Healthcare, Retail, BFSI, Manufacturing, Media, Government, Others).
Growth is primarily driven by the expansion of generative AI, multimodal AI models, autonomous vehicles, robotics, computer vision, and the need for high-quality labeled datasets for model training and evaluation.
The data annotation tools market is led by major manufacturers, including Scale AI, Appen, TELUS International, Labelbox, SuperAnnotate, Encord, Sama, iMerit, CloudFactory, Label Studio, V7, Dataloop, Hive, CVAT, and Amazon Web Services.
North America holds a 43% share, supported by advanced AI ecosystems, cloud infrastructure, leading AI developers, autonomous technology, robotics, and strong enterprise adoption of generative AI and computer vision.
Commercial Opportunities include AI-assisted annotation, multimodal data labelling, synthetic data generation, physical AI and robotics datasets, domain-specific annotation, and integrated data-quality and model-evaluation services.
- Échelle AI
- Appen
- TELUS International
- Boîte à étiquettes
- SuperAnnoter
- Enregistrement
- Sama
- IMerit
- CloudFactory
- Étiquette Studio
- V7
- Dataloop
- Vive
- TVA
- Services Web Amazon
About the Authors

Mayur Shinde
I am Mayur Shinde, a Senior Research Analyst at Transpire Insight, specializing in the Automotive & Transportation and Information & Communication Technology (ICT) Industry. My work focuses on analyzing emerging market trends, technological advancements, competitive landscapes, and industry developments to deliver accurate, data-driven insights. I am passionate about transforming complex market information into clear, actionable content that helps businesses, professionals, and decision-makers stay informed and make confident strategic decisions.

Chakradhar Khansole
Chakradhar serves as the Research Director at Transpire Insight, bringing over 8 years of experience in technology, innovation, and strategic market intelligence. He specializes in transforming complex market data into actionable business insights that enable organizations to make informed, growth-oriented decisions. Recognized for his strategic vision and analytical expertise, Chakradhar leads high-impact research initiatives, delivering comprehensive market assessments, competitive intelligence, and forward-looking industry analysis.
Rapports récemment publiés
-
Apr 2026
Marché des Profileur optique 3D
3d profileur optique taille du marché, rapport de part et d'analyse par type (desktop 3d profileur optique, et portable 3d profileur optique), par technologie (technologie confocale, et interférence de la lumière blanche), par industrie d'utilisation finale (industrie manufacturière, instituts de recherche, automobile, aérospatiale et défense, dispositifs médicaux, etc.), et géographie (amérique du nord, europe, asie-pacifique, moyen-orient et afrique, amérique du sud et centre), 2021 - 2031
-
Apr 2026
Marché des Capteur de profondeur
rapport d'analyse par type (capteurs de profondeur infrarouge, capteurs de temps de vol, capteurs de vision stéréo, capteurs de lumière structurés, capteurs de profondeur ultrasoniques), par application (automotive, robotique, jeu, électronique grand public, automatisation industrielle, soins de santé, sécurité et surveillance, autres), par les utilisateurs finaux (fabricants d'automobiles, entreprises d'électronique grand public, fournisseurs de soins de santé, entreprises industrielles, agences de sécurité, compagnies de jeux, entreprises de robotique, autres), et géographique (amérique du nord, europe, asie-pacifique, moyen-orient et afrique, amérique du sud et centre), 2021 – 2031
-
Apr 2026
Marché des Fabrication numérique
taille du marché de la fabrication numérique, rapport de part et d'analyse par composante (matériel, logiciel et services), par technologie (robotique, impression 3d, internet des objets (iot), etc.), par application (automobile et transport, aérospatiale et défense, électronique grand public, machines industrielles, etc.), par type de processus (conception par ordinateur, simulation par ordinateur, visualisation 3d, analyse, etc.), et géographie (amérique du nord, europe, asie-pacifique, moyen-orient et afrique, amérique du sud et amérique centrale), 2021 – 2031
-
Apr 2026
Marché des Services de visas numériques
services de visa numérique taille du marché, part et rapport d'analyse par type (voyageurs individuels, voyageurs de groupe), par demande (tourisme, voyage d'affaires, autres), et géographie (amérique du nord, europe, asie-pacifique, moyen-orient et afrique, amérique du sud et centre), 2021 – 2031